ESP-32快速内存复制
这篇文章将讨论如何在Xtensa(ESP-32)快速复制内存。文章分析了Xtensa CPU架构、内存模型、指令集支持。最后通过跑分测试验证通过汇编编写的适用于对齐数据的快速内存复制函数比ROM中提供的stdlib快10%。
ESP-32, ESP-IDF, Xtensa, 内存, RAM, ROM, 闪存, 缓存, ISA, 指令集架构, memcpy, 内存对齐, 跑分
--by Captdam @ Oct 13, 2026Index
我最近在搞一个ESP-32项目,即使用裸TCP搭建HTTP静态文件服务器。这里面,服务器主要做一件事:将数据从闪存或内存复制到TCP缓冲。
我在之前的文章ESP-32 TCP裸金属HTTP服务器和X86、ARM与Xtensa上微优化字符串比较中已经讨论了如何使用ESP-32搭建简单的基于TCP的HTTP服务器和不同CPU架构上对字符串操作的微优化。你或许可以先参考这两篇文章,因为这两篇文章包括了很多本文将使用的知识点。
本文中,我将探讨如何在Extensa(ESP-32内部使用的CPU)上高效地移动数据。具体来说:
-
ROM中提供的标准
memcpy()函数的速度与限制。 -
Xtensa平台上可以用作移动数据的指令。
-
使用汇编来编写一个比ROM中提供的标准
memcpy()函数更快的、用于4字节对齐数据的memcpy()函数。
这篇文章中,我们将参考两份文档:
-
Xtensa® Instruction Set Architecture (ISA) Summary,来自Cadence Design Systems。Xtensa是一个可定制CPU的IP core。该文档包括了CPU架构和指令集等信息。
-
ESP32 TRM (版本 5.8)(ESP32技术参考手册 版本 5.8),来自乐鑫信息科技。ESP-32整合了Xtensa CPU和各种外设。
内存模型
哈弗架构
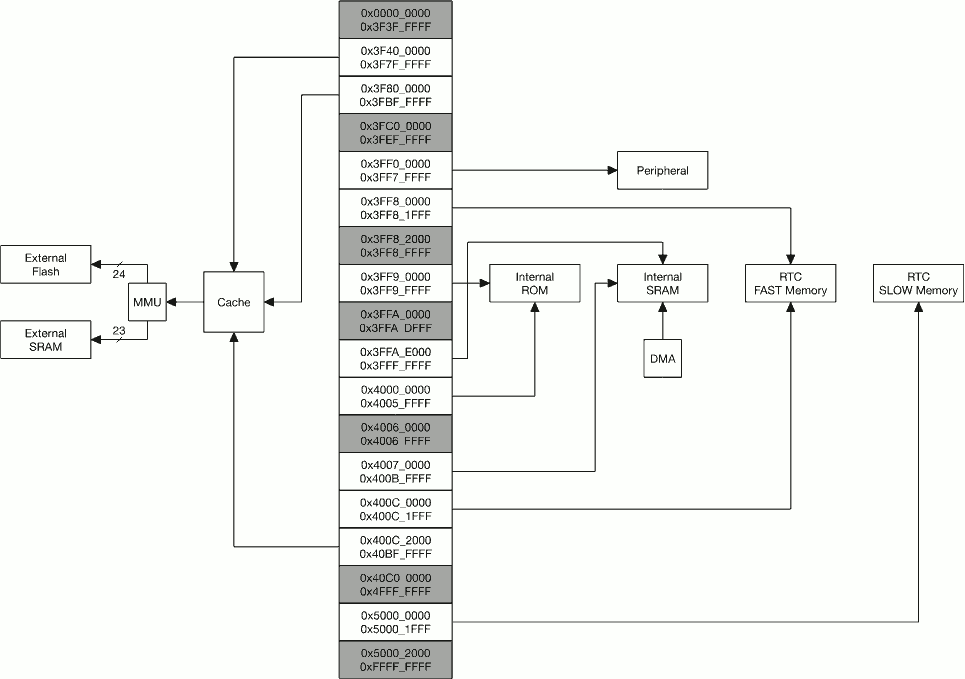
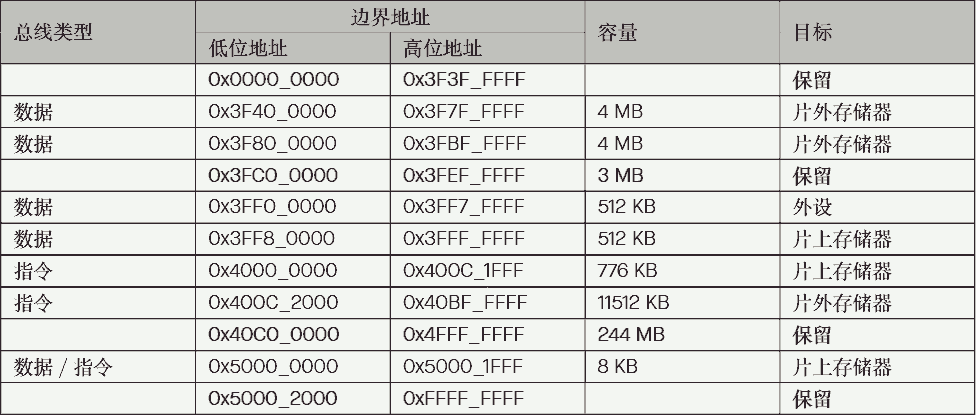
Xtensa是一款双核32位地址空间哈弗架构处理器。也就是说,有两条独立的内存总线分别负责数据与指令访问。ESP-32文档指出:
-
地址
0x4000_0000以下的部分属于数据总线的地址范围。 -
地址
0x4000_0000 ~ 0x4FFF_FFFF部分为指令总线的地址范围。 -
地址
0x5000_0000及以上的部分是数据总线与指令总线共用的地址范围。
违反指令/数据的访问模式会造成CPU异常,终止执行程序。
虽然内存地址总线是32位宽,支持4GB空间,一些区域是保留的(未连接),一些区域映射到同一块实际物理内存。
例如,如图所示,内部SRAM被同时映射到地址0x3FFAE000到0x3FFFFFFF的数据内存空间和地址0x40070000到0x400BFFFF的指令内存空间。
这有助于我们将数据保存在指令空间内。在程序初始化时,程序文本(包括指令和初始化数据)可以被一股脑载入SRAM中一块被同时映射到指令空间(以便执行)和数据空间(以便读写)的区块。否则,我们将必须把指令和数据分两次载入指令空间和数据空间。
内存种类
ESP-32内含多种不同类型的物理内存。
RAM
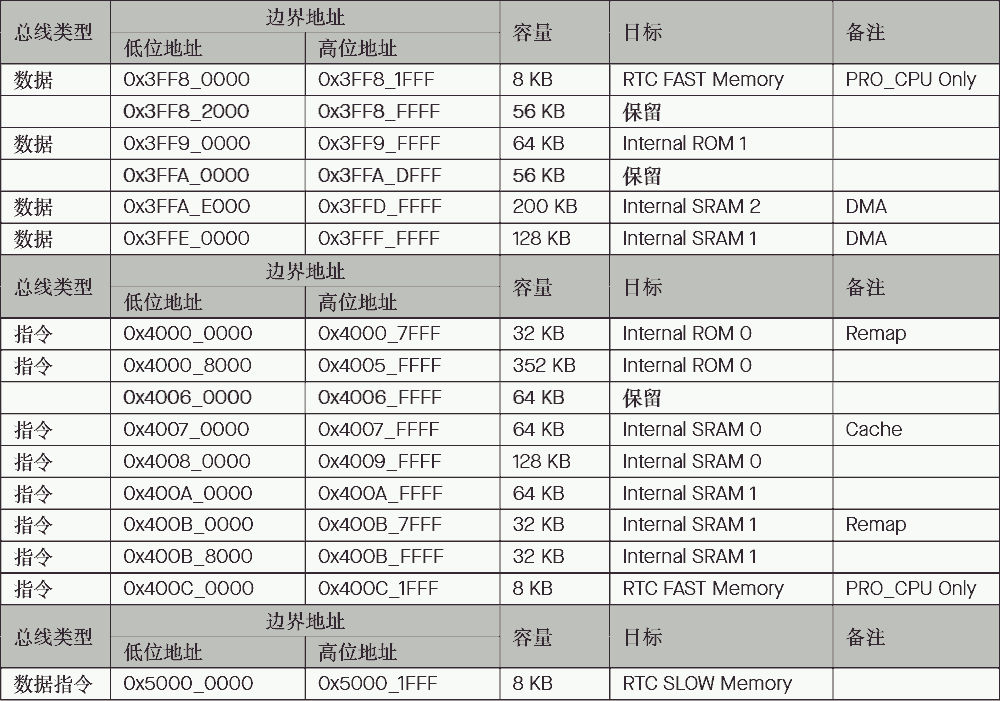
RAM,更确切地来讲,内部SRAM。这是我们的主内存,直接和CPU的内存总线相连。任何运行时需要的数据,包括栈、堆、全局(静态)变量都存放于此。同时,程序也需要被提前从闪存(或是其它外部设备)载入RAM后,其指令才能被CPU获取并执行,其数据才能被CPU读写。
Xtensa使用哈弗架构。虽然整个RAM都被映射在数据空间,但是只有其中部分RAM也被映射在指令空间。程序的指令和数据必须被放在相应的内存空间并使用正确的访问模式,否则,CPU将会异常。
RAM可以被拆分为3个部分:
-
RAM0为192kB,只能在指令空间访问。
-
RAM1为128kB,可以同时在指令空间和数据空间访问,但是排序词级相反。
-
RAM2为200kB,可以同时在指令空间和数据空间访问,且排序相同。
除非阻塞,访问(读、写、执行)RAM只需要一个CPU周期。
RAM使用静态RAM,即SRAM。注意这是一个电子工程词汇,表示由静态电路D型寄存器制成。和DRAM相反,不需要刷新电容。不要和编程语言的静态变量搞混了。
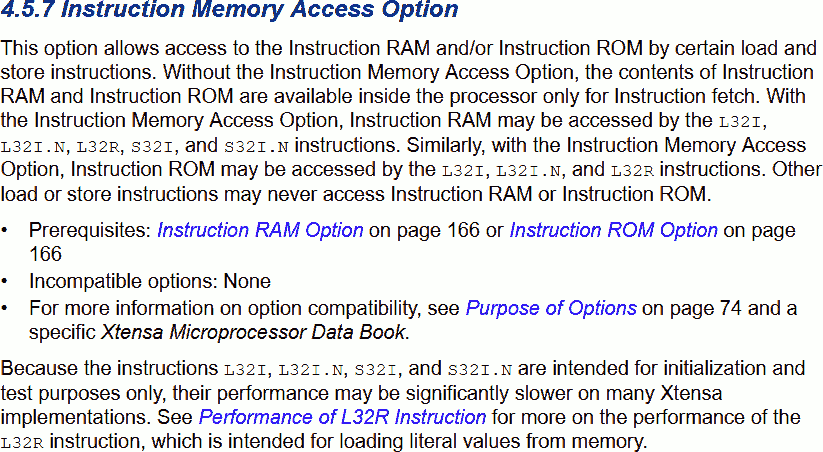
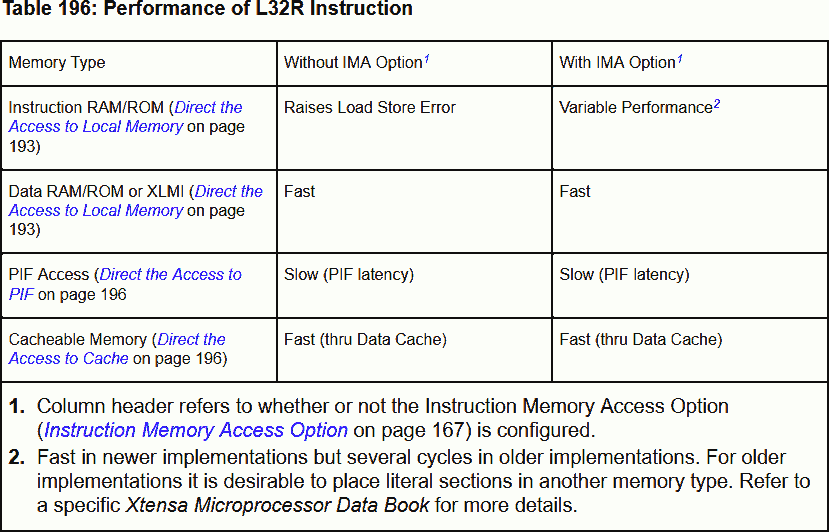
l32指令性能 - Xtensa指令集架构截屏参考Xtensa文档:Only the loads L32I, L32I.N, and L32R can access InstRAM and InstROM locations、Only the stores S32I and S32I.N can access InstRAM。
我们只能使用词访问指令空间,即l32指令。并且,访问指令空间比访问数据空间更慢。我未能在文档中找出访问指令空间需要的时钟周期与降低速度具体原因,我的猜测读取指令空间与执行指令空间会冲突,因此需要多个周期。
ROM
ROM是内部只读内存。正如其名,其内容在出厂时就烧录好,我们没办法修改(除非有几个小目标的实力可以订购一批自定义的芯片)。ROM中包含一级启动引导程序和一些常用函数,例如C标准库,包含memcpy()。
ROM可以被拆分为2个部分:
-
ROM0为384kB,只能在指令空间访问。其头部32kB可以被映射到RAM1(在指令空间和数据空间镜像),因此可以像数据一样访问。
-
ROM1为64kB,只能在数据空间访问。
除非阻塞,访问ROM只需要一个CPU周期。
闪存
闪存用于保存我们的程序(包括程序指令和初始化数据)。闪存掉电后仍能保存内容。
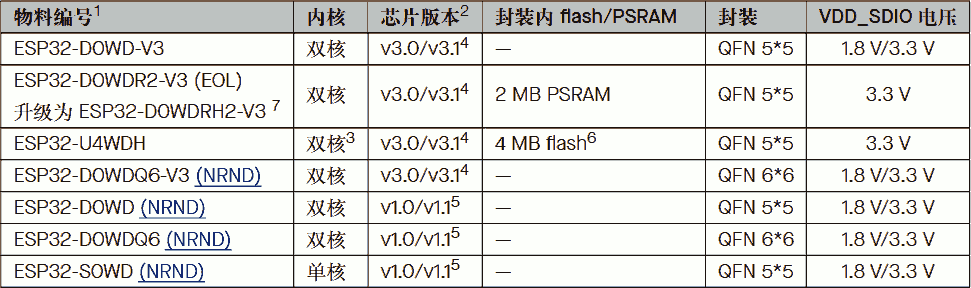
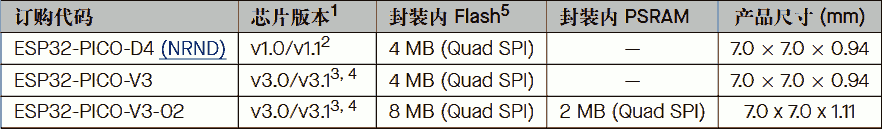
闪存可以在片外,通过PCB连接芯片(如ESP32-D0),也可以在片内但是CPU晶圆外,通过金属层/互连层连接CPU晶圆(如ESP32-PICO和ESP32-U40)无论如何,最重要的一点是,闪存不直接与CPU的内存总线相连。CPU既不能执行闪存上的指令,也不能读写闪存上的数据。
ESP-32支持最大16MB外部内存(这个说法好怪,谁最先把memory翻译成内存的?),如闪存和外部RAM,这能够保存对于嵌入式系统来说相当多的指令与数据了,除非拿来存图片或者视(谁家好人这么玩呀,接张SD卡吧)。
我们可以映射:
-
地址
0x3F400000到0x3F7FFFFF(4MB) - 外部闪存到数据空间以读取程序文本。 -
地址
0x3F800000到0x3FBFFFFF(4MB) - 外部RAM到数据空间以读写数据。 -
地址
0x400C2000到0x40BFFFFF(11512kB) - 外部闪存到指令空间以执行程序。地址
0x40000000到0x400C1FFF(776kB) - 被内部ROM与RAM占用。因此,只有11512kB空间可用。
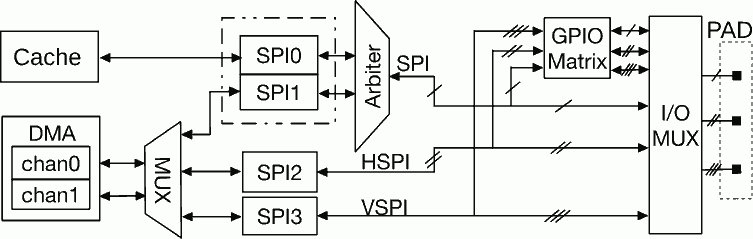
ESP-32支持SPI(DSPI、QSPI)外部内存。ESP-32共有4套SPI外设,其中SPI0用于读取外部内存。
缓存
因为闪存和外部内存不直接与CPU的内存总线相连,CPU自然无法访问它们。一个办法是手动通过SPI将内容读入内部RAM,无疑这很不优雅且低效。
缓存系统则可以用来在后台自动读取。缓存系统将外部内容暂时读入自己的zh内存中,以此将外部SPI闪存或外部SPI内存映射到其内部池中。这样,CPU就可以像是访问内部内存一样访问外部内容了。
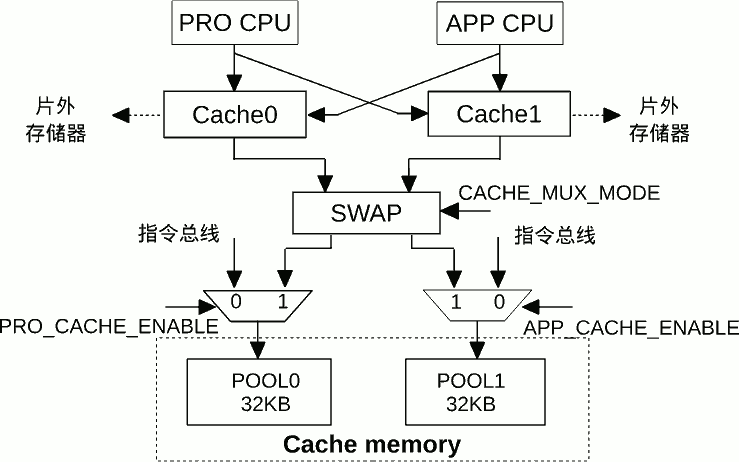
ESP-32有两个缓存池,各32kB,内部为32字节长的块。
下面是缓存的工作原理。当CPU需要特定内容(读数据或是执行指令),就会把该内容的地址至于内存总线上。如果这个地址属于外部设备(如闪存上的一条指令),该请求就会被路由到闪存系统。
缓存系统先检测需要的内容是否已存在与缓存系统内部的池中:
-
如果是,缓存命中,池中的内容被返回。除非阻塞,只消耗一个CPU周期。
-
如果否,缓存缺失。缓存系统将需要首先从外部设备读取该内容,覆盖池中副本,然后再返回池中(已更新的)内容。当读取外部设备时,当前指令会被阻塞。
数据分配
缓存
因为有缓存系统加持,我们可以在外部闪存上运行程序,亦或从外部闪存和外部RAM读取数据,就像是它们在内部一样。
但是,缓存池是有限的,只有两个32kB的缓存池用于外部程序和数据。也就是说,我们不可能缓存整个外部闪存或外部RAM。当CPU尝试读取没有被缓存的外部内容时,就会发生缓存缺失的问题,并且这个问题代价不小。
比如说,ESP-32的CPU与RAM运行频率为160MHz,读取一个32比特的(一个词)的RAM中或是已被缓存的内容只需要1各CPU周期,即6.25纳秒。外部Quad-SPI(四数据线SPI)设备一般运行在40MHz(如果距离远或是环境噪音严重,频率还会更低),则需要8个SPI周期(4比特每SPI周期)读取一个32比特的内容,即200纳秒。光是这样就慢了32倍,我们甚至还没考虑其它开销,比如SPI通讯地址段。
再者,因为缓存有限。我们在之前缓存的内容可能会被之后的内容覆盖,当我们再次访问之前爱你的内容时,我们将需要重新缓存之前的内容。
对于偶尔使用的程序和数据,或是我们对运行速度要求不高时,使用缓存并无大碍,不过是缓存缺失时速度慢点而已。除非你对SPI的噪音或是功耗有一些偏执的想法。
RAM
我们也可以把一些程序何数据强制放在RAM里面,这样,访问肯定就只要一个周期了。
在ESP-IDF的C语言中,可以通对程序和常量过添加IRAM_ATTR参数和对数据添加DRAM_ATTR参数来实现。注意,Xtensa使用哈弗架构,IRAM_ATTR将内容放在指令内存中,DRAM_ATTR放在数据内存中:
DRAM_ATTR int globalStaticData_inDataRAM;

IRAM_ATTR int function_in() {

	IRAM_ATTR const static int localStaticData_inInstRAM = 1;
	DRAM_ATTR const static int localStaticData_inDataRAM = 2;

	int localData_inStack = 3; // Stack is always in RAM
	const static int localConstData_inTextFlash = 4;
}
当程序初始化时,RAM程序与数据会被从闪存复制到RAM中,然后才执行主程序。
不过,RAM也不是无限的。我们没办法把整个程序文本都放在RAM中,只能顾及常用的或是对速度要求高的内容。至于没有被放进RAM的,只能在运行时依靠缓存系统来动态加载了。当然,代价就是缓存缺失时会阻塞。
RAM由32kB大小的块构成,多个上游设备同时访问同一个块会造成阻塞。
基准测试设置
本文中,我们将编写一个简单程序来测试从一个地方(来源)复制数据到另一个地方(目标):
#define MAXSIZE 2048

size_t len = 1024;
char dest[MAXSIZE];
char src[MAXSIZE];
memcpy(dest, src, len);
在32位系统上,编译器一般会将变量都放在对齐的地址上。内存对齐允许使用多字节操作,以提高性能。我们也可以通过添加__attribute__((aligned(size)))参数来确保对齐。
char __attribute__((aligned(4))) dest[MAXSIZE];
char __attribute__((aligned(4))) src[MAXSIZE];
我们将测量内存复制前后的CPU周期计数器以计算操作消耗的周期数。我们可以通过ESP-IDF提供的uint32_t cpu_hal_get_cycle_count()宏或是直接在汇编中读取CPU特殊寄存器rsr.ccount ax获取CPU周期。
#include "hal/cpu_hal.h"

uint32_t start = cpu_hal_get_cycle_count();
memcpy(dest, src, len);
uint32_t end = cpu_hal_get_cycle_count();
终端中打印周期数:
#include "esp_log.h"

ESP_LOGI("[Copy]", "%x <-- %x", dest, src);
ESP_LOGI("[Copy]", "Cycles %d: %d", i, end - start);
为了防止程序缓存缺失,消除数据缓存缺失以外,由于程序指令缓存缺失造成的阻塞周期,我们需要把整个程序指令都载入RAM。
#include "esp_attr.h"

IRAM_ATTR app_main() {

}
复制的目标只能是在RAM中:
-
数据RAM(静态):在函数外或是在函数内以
static声明,作为一个静态变量。 -
数据RAM(栈):在函数内声明。
-
指令RAM:写入指令RAM并不常见,除非是加载程序文本到RAM的情况。
来源则可以存在多种选择:
-
数据RAM(静态):在函数外或是在函数内以
static声明,作为一个静态变量。 -
数据RAM(栈):在函数内声明。
-
指令RAM:如果数据RAM不够用了,则可以使用指令RAM。但是,因为Xtensa采用哈弗架构,对访问指令RAM有一定限制。
-
闪存:量大管饱,但是可能会缓存缺失阻塞程序。
结合下来:
#include "esp_log.h"
#include "esp_attr.h"
#include "hal/cpu_hal.h"

#include <string.h>

#define MAXSIZE 2048
#define LEN 1

DRAM_ATTR char __attribute__((aligned(4))) dest[MAXSIZE]; // 数据RAM,静态

IRAM_ATTR void app_main(void) {
	char __attribute__((aligned(4))) src[MAXSIZE]; // 数据RAM,栈
//	const static char __attribute__((aligned(4))) src[MAXSIZE]; // 缓存闪存
//	DRAM_ATTR const static char __attribute__((aligned(4))) src[MAXSIZE]; // 数据RAM,静态
//	IRAM_ATTR const static char __attribute__((aligned(4))) src[MAXSIZE]; // 指令RAM

	ESP_LOGI("[Copy]", "%x <-- %x", dest, src);

	for (int i = 0; i < 5; i++) {
		uint32_t start = cpu_hal_get_cycle_count();

		memcpy(dest, src, LEN);

		uint32_t end = cpu_hal_get_cycle_count();
		ESP_LOGI("[Copy]", "Cycles %d: %d", i, end - start);
	}
}
对于每种情况我们都执行5次。第一次得到的周期数为缓存缺失时的结果,包括了从外部设备读取内容所需周期。之后四次的周期数为缓存命中的结果。
标准memcpy()
片内的ROM中提供了一个C标准库,包含memcpy()函数。不管我们是否使用,该函数都在这,出厂时就有了。
该函数位于地址0x4000c2c8。你可以反汇编ROM的ELF文件tool/esp-rom-elfs/20240305/esp32_rev300_rom.elf来查看其内容。
这里我就不再详述反汇编后该函数的机器码了。它确实是进行过(某种)优化的,例如,它一次复制4个4字节词以降低循环的额外开销。
你可以选择使用这个函数,或是不使用。如果使用,就不需要自己再写了,能节约一定闪存和指令RAM的空间。
测试
现在,让我们编译这个程序并载入ESP-32以进行测试。
在所有情况下,因为dest以DRAM_ATTR的方式作为全局变量声明,其地址为0x3FFB1E0C,即内部数据空间,指向内部SRAM2。
如果来源以const static声明,则位于闪存中程序文本内:
const static char __attribute__((aligned(4))) src[MAXSIZE];
在这种情况下,src的地址位于0x3F403830,即外部数据空间。
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 | 673 | 40 | 40 | 40 | 40 |
| 4 | 675 | 42 | 42 | 42 | 42 |
| 70 | 1984 | 86 | 86 | 86 | 86 |
| 128 | 3274 | 113 | 113 | 113 | 113 |
| 1024 | 21530 | 673 | 673 | 673 | 673 |
| 2047 | 42407 | 1325 | 1325 | 1325 | 1325 |
| 2048 | 42394 | 1313 | 1313 | 1313 | 1313 |
如果来源以默认方式声明,则位于函数栈内,且栈只可能是在数据RAM中:
char __attribute__((aligned(4))) src[MAXSIZE];
在这种情况下,src的地址位于0x3FFB43C0,即内部数据空间,指向内部SRAM2。
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 | 39 | 39 | 39 | 39 | 39 |
| 4 | 41 | 41 | 41 | 41 | 41 |
| 70 | 85 | 85 | 85 | 85 | 85 |
| 128 | 112 | 112 | 112 | 112 | 112 |
| 1024 | 672 | 672 | 672 | 672 | 672 |
| 2047 | 1324 | 1324 | 1324 | 1324 | 1324 |
| 2048 | 1312 | 1312 | 1312 | 1312 | 1312 |
如果来源以DRAM_ATTR const static声明,则位于数据RAM中:
DRAM_ATTR const static char __attribute__((aligned(4))) src[MAXSIZE];
在这种情况下,src的地址位于0x3FFB160C,即内部数据空间,指向内部SRAM2。
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 | 39 | 39 | 39 | 39 | 39 |
| 4 | 41 | 41 | 41 | 41 | 41 |
| 70 | 85 | 85 | 85 | 85 | 85 |
| 128 | 112 | 112 | 112 | 112 | 112 |
| 1024 | 672 | 672 | 672 | 672 | 672 |
| 2047 | 1324 | 1324 | 1324 | 1324 | 1324 |
| 2048 | 1313 | 1313 | 1313 | 1313 | 1313 |
如果来源以IRAM_ATTR const static声明,则位于指令RAM中:
IRAM_ATTR const static char __attribute__((aligned(4))) src[MAXSIZE];
在这种情况下,src的地址位于0x400835C8,即内部指令空间,指向内部SRAM0。
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 | LoadStoreError | ||||
| 4 | 48 | 48 | 48 | 48 | 48 |
| 70 | LoadStoreError | ||||
| 128 | 337 | 337 | 337 | 337 | 337 |
| 1024 | 2465 | 2465 | 2465 | 2465 | 2465 |
| 2047 | LoadStoreError | ||||
| 2048 | 4897 | 4897 | 4897 | 4897 | 4897 |
总结
| 长度 | 1 | 4 | 70 | 128 | 1024 | 2047 | 2048 | 速度(周期每字节,2048字节时) |
|---|---|---|---|---|---|---|---|---|
| 闪存(缺失) | 673 | 675 | 1984 | 3274 | 21530 | 42407 | 42394 | 20.700 |
| 闪存(命中) | 40 | 42 | 86 | 113 | 673 | 1325 | 1313 | 0.641 |
| 数据RAM(栈) | 39 | 41 | 85 | 112 | 672 | 1324 | 1312 | 0.641 |
| 数据RAM(静态) | 39 | 41 | 85 | 112 | 672 | 1324 | 1313 | 0.641 |
| 指令RAM | Error | 48 | Error | 337 | 2465 | Error | 4897 | 2.391 |
该结果表示:
-
使用标准库将
memcpy()函数带来约30+周期额外开销。就算只复制1个字节也需要花费40个周期。当数据长度增加后,平均每个字节所需周期将下降。 -
从内部数据RAM读取的速度为0.64周期每字节。
-
当读取外部内存(闪存)时,第一次读会花费额外的周期等待缓存加载。每字节消耗约21周期,比读内部数据RAM慢了40多倍。之后再从闪存读时消耗的周期和内部数据RAM相似。
-
从指令RAM读取的速度为2.39周期每字节,比从内部数据RAM读取慢约4倍。另外,当长度不是4的倍数时,CPU将报错,抛出一个
LoadStoreError异常。这是因为memcpy()内部使用l8指令进行字节读取和l16指令进行半词读取,但是指令内存只允许l32词读取。 -
复制2047字节比2048字节慢。因为
memcpy()在读取2047字节时需要使用多条短的读取和检测来复制最后3字节,而2048字节全用词读取即可。
我们的快速复制对齐数据
正如我在我的另一篇文章中提到,多字节访问词对齐的数据比单字节访问更高效。
也就是说,我们可以一次性复制4字节(一个词,32位机的一个词就是4字节),就比一次只复制一个字节快4倍:
for (int i = 0; i < len / 4; i++) {
	*((uint32_t*)dest) = *((uint32_t*)src);
	dest += 4;
	src += 4;
}
虽然两个缓冲的地址都是对齐的,但是长度却不一定。因此,我们仍然需要对最后的1到3字节使用单字节复制:
for (int i = 0; i < len % 4; i++) {
	*((char*)dest) = *((char*)src);
	dest++;
	src++;
}
举例,要复制“Hello memories!”,包括15个字符(不计算空结束符),我们需要复制:
-
Hell- 词访问 -
o me- 词访问 -
mori- 词访问 -
e- 字节访问 -
s- 字节访问 -
!- 字节访问
我们编译这段代码:
400835c4 <mycopy>:
400835c4:	004136        	entry	a1, 32
400835c7:	41b240        	srli	a11, a4, 2
400835ca:	fb9c      	beqz.n	a11, 400835ed <mycopy+0x29>
400835cc:	a0cb20        	addx4	a12, a11, a2
400835cf:	c08c20        	sub	a8, a12, a2
400835d2:	fcc882        	addi	a8, a8, -4
400835d5:	418280        	srli	a8, a8, 2
400835d8:	039d      	mov.n	a9, a3
400835da:	01c882        	addi	a8, a8, 1
400835dd:	078876        	loop	a8, 400835e8 <mycopy+0x24>
400835e0:	09a8      	l32i.n	a10, a9, 0
400835e2:	994b      	addi.n	a9, a9, 4
400835e4:	02a9      	s32i.n	a10, a2, 0
400835e6:	224b      	addi.n	a2, a2, 4
400835e8:	a03b30        	addx4	a3, a11, a3
400835eb:	0c2d      	mov.n	a2, a12
400835ed:	144040        	extui	a4, a4, 0, 2
400835f0:	d48c      	beqz.n	a4, 40083601 <mycopy+0x3d>
400835f2:	424a      	add.n	a4, a2, a4
400835f4:	000382        	l8ui	a8, a3, 0
400835f7:	331b      	addi.n	a3, a3, 1
400835f9:	004282        	s8i	a8, a2, 0
400835fc:	221b      	addi.n	a2, a2, 1
400835fe:	f29247        	bne	a2, a4, 400835f4 <mycopy+0x30>
40083601:	f01d      	retw.n0x33
老实说,编译结果并不理想。我决定自己用汇编手搓。
Xtensa指令集架构
在编写汇编代码前,我想要重点指出Xtensa的两条指令。
循环
Xtensa提供了一套零开销的循环指令:loop、loopnez和loopgtz:
my_loop:
	loopxxx, as, label_end
	inst1
	inst2
label_end:
	inst3
其中:
-
as- 循环数:-
loop- 如果as为零,则循环232次。 -
loopnez- 如果as为零,则跳过该循环。 -
loopgtz- 如果as小于或等于零,则跳过该循环。
-
-
label_end- 循环后的下一条指令的地址。
CPU内含3个特殊寄存器:
-
LCOUNT- 剩余循环数,为as- 1。 -
LBEG- 循环起点,即循环指令的下一条指令的地址。例子中为inst1。 -
LEND- 循环终点,即循环中最后一条指令的下一条指令的地址。例子中为inst3。
loopxxx可用于在进入循环前就确定循环数的条件下降低缓缓地开销。如果没有循环指令,我们将需要使用额外的指令以追踪循环数并跳转:
my_loop:
	inst1
	inst2
	addi	as, as, -1
	bnez	as, my_loop
label_end:
	inst3
注意,CPU内只有一套循环寄存器。因此,我们不能套嵌内外都使用loop指令的循环,在循环中调用子函数也有风险因为子函数可能使用loop指令。
哈弗架构
Xtensa使用哈弗架构,访问指令空间和数据空间模式不同。
-
数据空间允许直接访问、半词(16比特)访问和词(32字节)访问。
-
指令空间只允许词(32字节)访问。
要从指令空间读取,我们必须修改复制最后几字节的代码:
uint32_t last = *((uint32_t*)src);
	For (int i = 0; i < len % 4; i++) {
		*((char*)dest) = last;
		dest++;
		last >> 8;
}
这样,我们就使用词读取从来源读取一整个词(会包括几个额外字节),以满足指令空间要求的访问模式。
当长度不是4的倍数时,我们会额外读取几个字节。因为读没有副作用,这不会造成什么问题。
另外,内存是以页的方式分配给程序的,并且页的大小永远是4的倍数。也就是说,额外读取的几个字节仍然在当前页中,这也就不会出发out-of-bounds内存错误。
我们使用字节写来写入目标以防止误写。如果要写指令空间,则长度必须为4的倍数。
我们的代码
首先处理最后几个字节:
#define faststr_memcpy(dest, src, len) _faststr_memcpy((uint8_t*)dest, (uint8_t*)src, (size_t)len)
IRAM_ATTR void _faststr_memcpy(uint8_t* dest, uint8_t* src, size_t len) {
	asm volatile (
		"l32i	%[src], %[src], 0\n\t"
		"loopnez	%[len], 1f\n\t"
		"s8i	%[src], %[dest], 0\n\t"
		"srli	%[src], %[src], 8\n\t"
		"addi	%[dest], %[dest], 1\n\t"
		"1:	\n\t"
	:
		[src] "+a" (src),
		[dest] "+a" (dest)
	:
		[len] "a" (len)
	:
		"memory"
	);
}
在最开始:
-
dest- 目标缓冲的最后一个词的地址。 -
src- 来源缓冲的最后一个词的地址。 -
len- 最后一个词中需要复制的字节数,可以为0到3。
首先,将最后一个词读入src。这可能包含额外的数据。
如果len不为0,将最后一个词中需要复制的字节数载入循环计数器。在循环中:
-
将
src(内容)的低8位写入dest(指针)指向的地址。 -
右移
src(内容)8位,以将下一个字节移入低8位。 -
dest(指针)进一,以指向目标的下一个字节。
在最后:
-
dest- 目标最后一个字节的下一个字节的地址。 -
src- 覆盖。 -
len- 不变。
所有三个参数都不再需要。
现在,编写复制词复制的主体:
#define faststr_memcpy4(dest, src, len) _faststr_memcpy4((uint32_t*)dest, (uint32_t*)src, (size_t)len)
IRAM_ATTR void _faststr_memcpy4(uint32_t* dest, uint32_t* src, size_t len) {
	uint32_t next = len & 0b11;
	len /= 4;
	asm volatile (
		"loopnez	%[len], 1f\n\t"
		"l32i	%[len], %[src], 0\n\t"
		"s32i	%[len], %[dest], 0\n\t"
		"addi	%[src], %[src], 4\n\t"
		"addi	%[dest], %[dest], 4\n\t"
		"1:	\n\t"
	:
		[len] "+a" (len),
		[src] "+a" (src),
		[dest] "+a" (dest)
	:
	:
		"memory"
	);
	faststr_memcpy(dest, src, next);
}
在最开始:
-
dest- 目标缓冲的地址。 -
src- 来源缓冲的地址。 -
len- 需要复制的字节数。
首先,计算:
-
next- 最后一个词中需要复制的字节数,可以为0到3。 -
len- 需要复制的词数。
如果len不为0,将复制的词数载入循环计数器。在循环中:
-
len不再需要,可以用作临时数据。 -
从
src(指针)指向的地址读一个词,写入len(临时内容)。 -
从
len(临时内容)写一个词到dest(指针)指向的地址。 -
src(指针)和dest(指针)进4(词的大小)。
对于每4字节,我们进行1次读、1次写、2次进位。也就是说,4字节共4周期,即1周期每字节。这里,额外开销为为了进位2个指针消耗的2周期。
在最后:
-
dest- 目标缓冲的最后一个词的地址。 -
src- 来源缓冲的最后一个词的地址。 -
len- 覆盖。
dest和src可以用于调用faststr_memcpy(dest, src, len)。
为了降低指针进位带来的额外消耗,我们可以进行多次带偏移量的读写,循环最后再给指针进位总量:
#define faststr_memcpy48(dest, src, len) _faststr_memcpy48((uint32_t*)dest, (uint32_t*)src, (size_t)len)
IRAM_ATTR void _faststr_memcpy48(uint32_t* dest, uint32_t* src, size_t len) {
	uint32_t next = len & 0b11111;
	len /= 32;
	asm volatile (
		"loopnez	%[len], 1f\n\t"
		"l32i	%[len], %[src], 0\n\t"
		"s32i	%[len], %[dest], 0\n\t"
		"l32i	%[len], %[src], 4\n\t"
		"s32i	%[len], %[dest], 4\n\t"
		"l32i	%[len], %[src], 8\n\t"
		"s32i	%[len], %[dest], 8\n\t"
		"l32i	%[len], %[src], 12\n\t"
		"s32i	%[len], %[dest], 12\n\t"
		"l32i	%[len], %[src], 16\n\t"
		"s32i	%[len], %[dest], 16\n\t"
		"l32i	%[len], %[src], 20\n\t"
		"s32i	%[len], %[dest], 20\n\t"
		"l32i	%[len], %[src], 24\n\t"
		"s32i	%[len], %[dest], 24\n\t"
		"l32i	%[len], %[src], 28\n\t"
		"s32i	%[len], %[dest], 28\n\t"
		"addi	%[src], %[src], 32\n\t"
		"addi	%[dest], %[dest], 32\n\t"
		"1:	\n\t"
	:
		[len] "+a" (len),
		[src] "+a" (src),
		[dest] "+a" (dest)
	:
	:
		"memory"
	);
	faststr_memcpy4(dest, src, next);
}
我决定以32字节为一个块,因为缓存的块长度也是32字节。
循环内部的程序文本不能超过256字节。
在最开始:
-
dest- 目标缓冲的地址。 -
src- 来源缓冲的地址。 -
len- 需要复制的字节数。
首先,计算:
-
next- 最后一个块中需要复制的字节数,可以为0到31。 -
len- 需要复制的块数。
如果len不为0,将复制的块数载入循环计数器。在循环中:
-
len不再需要,可以用作临时数据。 -
从
src(指针)指向的地址读一个词,写入len(临时内容)。 -
从
len(临时内容)写一个词到dest(指针)指向的地址。 -
从
src+4(指针)指向的地址读一个词,写入len(临时内容)。 -
从
len(临时内容)写一个词到dest+4(指针)指向的地址。 -
继续,直到总计读写32字节,即一个块。
-
src(指针)和dest(指针)进32。
对于每32字节,我们进行8次读、8次写、2次进位。也就是说,32字节共18周期,约半个周期每字节。
在最后:
-
dest- 目标缓冲的最后一个块的地址。 -
src- 来源缓冲的最后一个块的地址。 -
len- 覆盖。
dest和src可以用于调用faststr_memcpy4(dest, src, len)。
测试
现在,让我们编译这个程序并载入ESP-32以进行测试。
400835b8 <_faststr_memcpy48>:
400835b8:	004136        	entry	a1, 32
400835bb:	418540        	srli	a8, a4, 5
400835be:	259876        	loopnez	a8, 400835e7 <_faststr_memcpy48+0x2f>
400835c1:	0388      	l32i.n	a8, a3, 0
400835c3:	0289      	s32i.n	a8, a2, 0
400835c5:	1388      	l32i.n	a8, a3, 4
400835c7:	1289      	s32i.n	a8, a2, 4
400835c9:	2388      	l32i.n	a8, a3, 8
400835cb:	2289      	s32i.n	a8, a2, 8
400835cd:	3388      	l32i.n	a8, a3, 12
400835cf:	3289      	s32i.n	a8, a2, 12
400835d1:	4388      	l32i.n	a8, a3, 16
400835d3:	4289      	s32i.n	a8, a2, 16
400835d5:	5388      	l32i.n	a8, a3, 20
400835d7:	5289      	s32i.n	a8, a2, 20
400835d9:	6388      	l32i.n	a8, a3, 24
400835db:	6289      	s32i.n	a8, a2, 24
400835dd:	7388      	l32i.n	a8, a3, 28
400835df:	7289      	s32i.n	a8, a2, 28
400835e1:	20c332        	addi	a3, a3, 32
400835e4:	20c222        	addi	a2, a2, 32
400835e7:	248240        	extui	a8, a4, 2, 3
400835ea:	079876        	loopnez	a8, 400835f5 <_faststr_memcpy48+0x3d>
400835ed:	0388      	l32i.n	a8, a3, 0
400835ef:	0289      	s32i.n	a8, a2, 0
400835f1:	334b      	addi.n	a3, a3, 4
400835f3:	224b      	addi.n	a2, a2, 4
400835f5:	144040        	extui	a4, a4, 0, 2
400835f8:	0338      	l32i.n	a3, a3, 0
400835fa:	079476        	loopnez	a4, 40083605 <_faststr_memcpy48+0x4d>
400835fd:	004232        	s8i	a3, a2, 0
40083600:	413830        	srli	a3, a3, 8
40083603:	221b      	addi.n	a2, a2, 1
40083605:	f01d      	retw.n
这里展示了编译器生成的机器码,可以看到我们的代码位于地址0x400835B8,即内部指令内存空间,目标为内部SRAM0。
另外,编译器将词复制_faststr_memcpy4合并在地址0x400835EA,将字节复制_faststr_memcpy合并在地址0x400835F8。
我们将测试:
-
词复制 - 调用
faststr_memcpy4()。 -
块复制 - 调用
faststr_memcpy48(),其内部为最后一个快调用faststr_memcpy4()。
在所有情况下,因为dest以DRAM_ATTR的方式作为全局变量声明,其地址为0x3FFB1E0C,即内部数据空间。(和使用标准库时相同)
如果来源以const static声明,地址位于0x3F403830,即外部数据空间。(和使用标准库时相同)
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 (块) | 670 | 37 | 37 | 37 | 37 |
| 1 (词) | 653 | 21 | 21 | 21 | 21 |
| 4 (块) | 672 | 39 | 39 | 39 | 39 |
| 4 (词) | 655 | 22 | 22 | 22 | 22 |
| 70 (块) | 1970 | 69 | 69 | 69 | 69 |
| 70 (词) | 1981 | 84 | 84 | 84 | 84 |
| 128 (块) | 3266 | 100 | 100 | 100 | 100 |
| 128 (词) | 3301 | 140 | 140 | 140 | 140 |
| 1024 (块) | 21466 | 604 | 604 | 604 | 604 |
| 1024 (词) | 21894 | 1036 | 1036 | 1036 | 1036 |
| 2047 (块) | 42282 | 1195 | 1195 | 1195 | 1195 |
| 2047 (词) | 43145 | 2063 | 2063 | 2063 | 2063 |
| 2048 (块) | 42266 | 1180 | 1180 | 1180 | 1180 |
| 2048 (词) | 43142 | 2060 | 2060 | 2060 | 2060 |
如果来源以默认方式声明,地址位于0x3FFB43C0,即内部数据空间,指向内部SRAM2。(和使用标准库时相同)
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 (块) | 37 | 37 | 37 | 37 | 37 |
| 1 (词) | 21 | 21 | 21 | 21 | 21 |
| 4 (块) | 38 | 38 | 38 | 38 | 38 |
| 4 (词) | 22 | 22 | 22 | 22 | 22 |
| 70 (块) | 68 | 68 | 68 | 68 | 68 |
| 70 (词) | 84 | 84 | 84 | 84 | 84 |
| 128 (块) | 100 | 100 | 100 | 100 | 100 |
| 128 (词) | 140 | 140 | 140 | 140 | 140 |
| 1024 (块) | 604 | 604 | 604 | 604 | 604 |
| 1024 (词) | 1036 | 1036 | 1036 | 1036 | 1036 |
| 2047 (块) | 1195 | 1195 | 1195 | 1195 | 1195 |
| 2047 (词) | 2063 | 2063 | 2063 | 2063 | 2063 |
| 2048 (块) | 1180 | 1180 | 1180 | 1180 | 1180 |
| 2048 (词) | 2060 | 2060 | 2060 | 2060 | 2060 |
如果来源以DRAM_ATTR const static声明,地址位于0x3FFB160C,即内部数据空间,指向内部SRAM2。(和使用标准库时相同)
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 (块) | 37 | 37 | 37 | 37 | 37 |
| 1 (词) | 21 | 21 | 21 | 21 | 21 |
| 4 (块) | 38 | 38 | 38 | 38 | 38 |
| 4 (词) | 22 | 22 | 22 | 22 | 22 |
| 70 (块) | 68 | 68 | 68 | 68 | 68 |
| 70 (词) | 84 | 84 | 84 | 84 | 84 |
| 128 (块) | 100 | 100 | 100 | 100 | 100 |
| 128 (词) | 140 | 140 | 140 | 140 | 140 |
| 1024 (块) | 604 | 604 | 604 | 604 | 604 |
| 1024 (词) | 1036 | 1036 | 1036 | 1036 | 1036 |
| 2047 (块) | 1195 | 1195 | 1195 | 1195 | 1195 |
| 2047 (词) | 2063 | 2063 | 2063 | 2063 | 2063 |
| 2048 (块) | 1181 | 1181 | 1181 | 1181 | 1181 |
| 2048 (词) | 2060 | 2060 | 2060 | 2060 | 2060 |
如果来源以IRAM_ATTR const static声明,址位于0x40083608,即内部指令空间,指向内部SRAM0。(和使用标准库时相同,因为指令RAM中添加了我们的复制函数)另外,其地址紧接在我们的块复制函数后。
| 长度 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 |
|---|---|---|---|---|---|
| 1 (块) | 45 | 45 | 45 | 45 | 45 |
| 1 (词) | 29 | 29 | 29 | 29 | 29 |
| 4 (块) | 53 | 53 | 53 | 53 | 53 |
| 4 (词) | 37 | 37 | 37 | 37 | 37 |
| 70 (块) | 195 | 195 | 195 | 195 | 195 |
| 70 (词) | 211 | 211 | 211 | 211 | 211 |
| 128 (块) | 331 | 331 | 331 | 331 | 331 |
| 128 (词) | 372 | 372 | 372 | 372 | 372 |
| 1024 (块) | 2403 | 2403 | 2403 | 2403 | 2403 |
| 1024 (词) | 2836 | 2836 | 2836 | 2836 | 2836 |
| 2047 (块) | 4779 | 4779 | 4779 | 4779 | 4779 |
| 2047 (词) | 5647 | 5647 | 5647 | 5647 | 5647 |
| 2048 (块) | 4771 | 4771 | 4771 | 4771 | 4771 |
| 2048 (词) | 5652 | 5652 | 5652 | 5652 | 5652 |
总结
| 长度 | 1 | 4 | 70 | 128 | 1024 | 2047 | 2048 | 速度(周期每字节,2048字节时) |
|---|---|---|---|---|---|---|---|---|
| 闪存(缺失) - 块 | 670 | 672 | 1970 | 3266 | 21466 | 42282 | 42266 | 20.638 |
| 闪存(缺失) - 词 | 653 | 655 | 1981 | 3301 | 21894 | 43145 | 43142 | 21.065 |
| 闪存(命中) - 块 | 37 | 39 | 69 | 100 | 604 | 1195 | 1180 | 0.576 |
| 闪存(命中) - 词 | 21 | 22 | 84 | 140 | 1036 | 2063 | 2060 | 1.006 |
| 数据RAM(栈) - 块 | 37 | 38 | 68 | 100 | 604 | 1195 | 1180 | 0.576 |
| 数据RAM(栈) - 词 | 21 | 22 | 84 | 140 | 1036 | 2063 | 2060 | 1.006 |
| 数据RAM(静态) - 块 | 37 | 38 | 68 | 100 | 604 | 1195 | 1181 | 0.577 |
| 数据RAM(静态) - 词 | 21 | 22 | 84 | 140 | 1036 | 2063 | 2060 | 1.006 |
| 指令RAM - 块 | 45 | 53 | 195 | 331 | 2403 | 4779 | 4771 | 2.330 |
| 指令RAM - 词 | 29 | 37 | 211 | 372 | 2836 | 5647 | 5652 | 2.760 |
该结果表示:
-
使用32字节块复制
faststr_memcpy48()函数带来约30+周期额外开销,但使用4字节词复制faststr_memcpy4()函数只带来约30周期额外开销。块复制适合于长数据,词复制适合于短数据。 -
从内部数据RAM使用块复制的速度为0.58周期每字节,词复制为1.01周期每字节。
-
当读取外部内存(闪存)时,第一次读会花费额外的周期等待缓存加载。每字节消耗约21周期,比读内部数据RAM慢了40多倍。之后再从闪存读时消耗的周期和内部数据RAM相似。
-
从指令RAM使用块复制的速度为2.33周期每字节,词复制为2.76周期每字节,比内部数据RAM慢。
-
复制2047字节比2048字节慢。因为我们的代码在读取2047字节时需要使用多条短的读取和检测来复制最后3字节,而2048字节全用词读取即可。
我们的代码对比标准库
| 长度 | 1 | 4 | 70 | 128 | 1024 | 2047 | 2048 | 速度(周期每字节,2048字节时) |
|---|---|---|---|---|---|---|---|---|
| 闪存(缺失) - 标准库 | 673 | 675 | 1984 | 3274 | 21530 | 42407 | 42394 | 20.700 (基准) |
| 闪存(缺失) - 块 | 670 | 672 | 1970 | 3266 | 21466 | 42282 | 42266 | 20.638 (+0.3%) |
| 闪存(缺失) - 词 | 653 | 655 | 1981 | 3301 | 21894 | 43145 | 43142 | 21.065 (-1.8%) |
| 闪存(命中) - 标准库 | 40 | 42 | 86 | 113 | 673 | 1325 | 1313 | 0.641 (基准) |
| 闪存(命中) - 块 | 37 | 39 | 69 | 100 | 604 | 1195 | 1180 | 0.576 (+10.1%) |
| 闪存(命中) - 词 | 21 | 22 | 84 | 140 | 1036 | 2063 | 2060 | 1.006 (-56.9%) |
| 数据RAM(栈) - 标准库 | 39 | 41 | 85 | 112 | 672 | 1324 | 1312 | 0.641 (基准) |
| 数据RAM(栈) - 块 | 37 | 38 | 68 | 100 | 604 | 1195 | 1180 | 0.576 (+10.1%) |
| 数据RAM(栈) - 词 | 21 | 22 | 84 | 140 | 1036 | 2063 | 2060 | 1.006 (-57.0%) |
| 数据RAM(静态) - 标准库 | 39 | 41 | 85 | 112 | 672 | 1324 | 1313 | 0.641 (基准) |
| 数据RAM(静态) - 块 | 37 | 38 | 68 | 100 | 604 | 1195 | 1181 | 0.577 (+10.1%) |
| 数据RAM(静态) - 词 | 21 | 22 | 84 | 140 | 1036 | 2063 | 2060 | 1.006 (-56.9%) |
| 指令RAM - 标准库 | Error | 48 | Error | 337 | 2465 | Error | 4897 | 2.391 (基准) |
| 指令RAM - 块 | 45 | 53 | 195 | 331 | 2403 | 4779 | 4771 | 2.330 (+2.6%) |
| 指令RAM - 词 | 29 | 37 | 211 | 372 | 2836 | 5647 | 5652 | 2.760 (-15.4%) |
我们的代码和ROM中标准库相比:
-
对于数据RAM和已缓存的闪存,我们的块复制比标准库快10%。
-
对于指令RAM和未缓存的闪存,我们的块复制比标准库略快。
-
对于短的数据,我们的词复制更快。
-
我们的代码支持访问指令RAM。
,但是:
-
我们的代码要求目标和来源地址都必须是4字节对齐的。
对于内存种类:
-
数据RAM是首选。
-
缓存的外部存储和内部数据RAM性能相当。但是,缓存可能被其它内容覆盖,也就是说,使用缓存的表现是不可预测的。
-
指令RAM比数据RAM慢4倍,并且对访问模式有要求。但是,使用指令RAM的表现是可预测的。
内存阻塞
ESP-32内含两个CPU核心与多个DMA。换言之,将有多个主机(核心与DMA)同时访问内存。
RAM由多个32kB(0x8000)的区块组成,每个区块同时只能响应一个主机。当多个主机同时访问同一区块时,速度就会受限。
我将通过启用第二个核心持续写目标来模拟内存阻塞。
DRAM_ATTR char __attribute__((aligned(4))) dest[MAXSIZE];
IRAM_ATTR void spin(void* param) {
	uint32_t tmp;
	asm volatile (
		"1:	\n\t"
		"movi	%[tmp], -1\n\t"
		"loopnez	%[tmp], 2f\n\t"
		"s32i	%[tmp], %[dest], 0\n\t"
		"2:	\n\t"
		"j	1b\n\t"
	:
		[tmp] "=&a" (tmp)
	:
		[dest] "a" (dest)
	:
		"memory"
	);
}

IRAM_ATTR void app_main(void) {
	xTaskCreatePinnedToCore(spin, "Spin", 2048, NULL, 15, NULL, APP_CPU_NUM);
	vTaskDelay(1000 / portTICK_PERIOD_MS);

	/* Benchmarking */
}
第二个核心将执行spin。这里面,使用一个零开销的循环来以1访问每周期的频率访问dest。
另外,我们还将添加另一个目标dest2,大小为32kB并且以32kB对齐。这样dest2就可以完全占用一个区块。
DRAM_ATTR char __attribute__((aligned(32*1024))) dest2[32*1024];
我们将使用我们创建的32字节块复制。在这个函数中,对于每32字节,我们进行8次读、8次写、2次指针进位。也就是说,88%的时间下,每周期进行0.5次读和每周期进行0.5次写。
开测:
第一个核心执行_faststr_memcpy48,其地址位于0x40083740,即区块0x40080000。换言之,第一个核心每周期执行区块0x400800001次。
第二个核心执行spin,其地址位于0x40082570,即区块0x40080000。换言之,第二个核心每周期执行区块0x400800001次。
第二个核心写入dest,其地址位于0x3FFC0000,即区块0x3FFC0000。频率为每周期1次。
| 情况 | 目标 | 来源 | 测试1 | 测试2 | 测试3 | 测试4 | 测试5 | ||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | dest | 0x3FFC0000 | +0000 | 闪存 | 0x3F400000 | +30D8 | 42269 | 1180 | 1180 | 1180 | 1180 |
| 2 | dest | 0x3FFC0000 | +0000 | 数据RAM | 0x3FFC0000 | +2CE0 | 2069 | 2069 | 2069 | 2069 | 2069 |
| 3 | dest2 | 0x3FFB8000 | +0000 | 数据RAM | 0x3FFC0000 | +2CE0 | 1181 | 1181 | 1181 | 1181 | 1181 |
| 4 | dest | 0x3FFC0000 | +0000 | 指令RAM | 0x40080000 | +3790 | 4771 | 4771 | 4771 | 4771 | 4771 |
结果很有趣:
-
吞吐量不变:每个词消耗2周期。具体情况:
-
数据RAM区块
0x3FFC0000- 1.5次访问每周期:核心1写0.5次、核心2写1次。 -
Flash
0x3F400000- 0.5次访问每周期:核心1读0.5次。 -
指令RAM区块
0x40080000- 2次访问每周期:核心1执行1次、核心2执行1次。
-
-
吞吐量减半:每个词消耗4周期。具体情况:
-
数据RAM区块
0x3FFC0000- 2次访问每周期:核心1读0.5次、核心1写0.5次、核心2写1次。 -
指令RAM区块
0x40080000- 2次访问每周期:核心1执行1次、核心2执行1次。
-
-
吞吐量不变:每个词消耗2周期。具体情况:
-
数据RAM区块
0x3FFC0000- 1.5次访问每周期:核心1读0.5次、核心2写1次。 -
数据RAM区块
0x3FFB8000- 0.5次访问每周期:核心1写0.5次。 -
指令RAM区块
0x40080000- 2次访问每周期:核心1执行1次、核心2执行1次。
-
-
吞吐量不变:每个词消耗8周期。具体情况:
-
数据RAM区块
0x3FFC0000- 1.5次访问每周期: 0.5 writes from core 1, 1 write from core 2. -
指令RAM区块
0x40080000- 2.5次访问每周期:核心1读0.5次、核心1执行1次、核心2执行1次。
-
对于数据RAM,当访问频率达到2时,吞吐量减半。对于指令RAM,或许是因为其速度本来就慢,或因为有CPU指令缓存,吞吐量并无改变。